# SSLStrip 的未来 —— HTTPS 前端劫持
Author: 乌云历史资料库 (@wooyun_archive)
Published: 2014-10-17T08:22:00Z
Canonical: https://wepostx.com/topics/595
> 乌云历史资料归档
>
> **原始作者:** EtherDream
> **原始编号:** superkieran-wooyundrops:366
> **原始发布时间:** 2014-10-17 16:22
> **声明:内容仅用于技术研究和个人使用,版权归 wooyun.org。**
---
## 0x00 前言
在之前介绍的流量劫持文章里,曾提到一种『HTTPS 向下降级』的方案 —— 将页面中的 HTTPS 超链接全都替换成 HTTP 版本,让用户始终以明文的形式进行通信。
看到这,也许大家都会想到一个经典的中间人攻击工具 —— SSLStrip,通过它确实能实现这个效果。
不过今天讲解的,则是完全不同的思路,一种更有效、更先进的解决方案 —— HTTPS 前端劫持。
## 0x01 后端的缺陷
在过去,流量劫持基本通过后端来实现,SSLStrip 就是个典型的例子。
类似其他中间人工具,纯后端的实现只能操控最原始的流量数据,这严重阻碍了向更高层次的发展,面临众多难以解决的问题。
- 动态元素怎么办?
- 如何处理数据包分片?
- 性能消耗能否降低?
- ......
### 动态元素
在 Web 刚出现的年代里,SSLStrip 这样的工具还是大有用武之地的。那时的网页都以静态为主,结构简单层次清晰。在流量上进行替换,完全能够胜任。
然而,如今的网页日益复杂,脚本所占比重越来越多。如果仅仅从流量上着手,显然力不从心。
```text
#!js var protocol = 'https'; document.write('Login');
```
即使非常简单的动态元素,后端也毫无招架之力。
### 分片处理
分块传输的道理大家都明白。对于较大的数据,一口气是无法传完的。客户端依次收到各个数据块,最终才能合并成一个完整的网页。
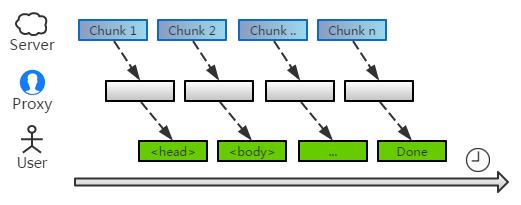
由于每次收到的都是残缺的碎片,这给链接替换带来很大的麻烦。加上不少页面并非标准的 UTF-8 编码,因此更是难上加难。
为了能顺利进行,中间人通常先收集数据,等到页面接收完整,才开始替换。
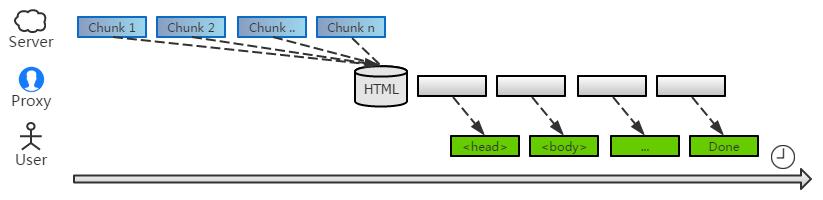
如果把数据比作水流,这个代理就像大坝一样,拦截了源源不断往下流的水,直到蓄满了才开始释放。因此,下游的人们需忍受很久的干旱,才能等到水源。
### 性能消耗
由于 HTML 兼容众多历史遗留规范,因此替换工作并非是件轻松事。
各种复杂的正则表达式,消耗着不少的 CPU 资源。尽管用户最终点击的只是其中一两个链接,但中间人并不知道将会是哪个,因此仍需分析整个页面。这不得不说是个悲哀。
## 0x02 前端的优势
如果我们的中间人能打入到页面的前端,那么情况会不会有所改善呢?
### 分片处理
首先,要派一名间谍到页面里。这是非常容易办到的:
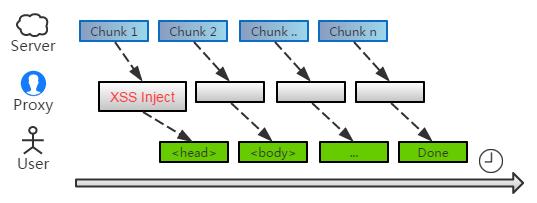
不像超链接遍布在页面各处,脚本插入到头部即可运行了。所以我们根本不用整个页面的数据,只需改造下第一个 chunk 就可以,后续的数据仍然交给系统转发。
因此,整个代理的时间几乎不变!
### 动态元素
很好,我们轻易渗透到页面里。但接着又如何发起进攻?
既然到了前端里,方法就相当多了。最简单的,就是遍历超链接元素,将 https 的都替换成 http 版本。
这个想法确实不错,但仍停留在 SSLStrip 思维模式上。还是『替换』这条路,只是从后端搬到前端而已。
尽管这个方法能胜任大多场合,但仍然不是最完美的。我们并不知道动态元素何时会添加进来,因此需要开启定时器不断的扫描。这显然是个很挫的办法。
### 性能优化
事实上,超链接无论是谁产生的、何时添加进来的,只要不点击,都是不起作用的。所以,我们只需关心何时去点击就可以 —— 如果我们的程序,能在点击产生的第一时间里控制住现场,那么之后的流程就可由我们决定了。
听起来似乎很玄乎,不过在前端,这只是小菜一碟的事。点击,不过个事件而已。既然是事件,我们用最基础的事件捕获机制,即可将其轻松拿下:
```text
#!js document.addEventListener('click', function(e) { // ... }, true);
```
DOM-3-Event 是个非常有意义的事件模型。之前用它来实现『[内联 XSS 拦截](http://fex.baidu.com/blog/2014/06/xss-frontend-firewall-1/)』,如今同样也可以用来劫持链接。
我们捕获全局的点击事件,如果发现有落在 https 超链接上,果断将其......拦截?
如果真把它拦截了,那新页面就不会出现了。当然你会说,可以自己 window.open 弹一个,反正点击事件里是可以弹窗的。
不过,请别忘了,并非所有的超链接都是弹窗,也有不少是直接跳转的。你也会说可以修改 location 来实现。
但要识别是『弹窗』还是『跳转』,并不简单。除了超链接的 target 属性,页面里的 元素也会有影响。当然,这些相信你都能处理好。
然而,现实未必都是那么简单的。有些超链接本身就绑定了 onclick 事件,甚至在其中 return false 或 preventDefault,屏蔽了默认行为。如果我们不顾及这些,仍然模拟跳转或弹窗,那就违背页面的意愿了。
事实上,有一个非常简单的办法:当我们的捕获程序运行时,新页面还远没出现,这时仍有机会修改超链接的 href。待事件冒泡完成、执行默认行为时,浏览器才读取 href 属性,作为最终的结果。
因此,我们只需捕获点击事件,修改超链接地址就可以了。至于是跳转、弹窗、还是被屏蔽,根本不用我们关心。
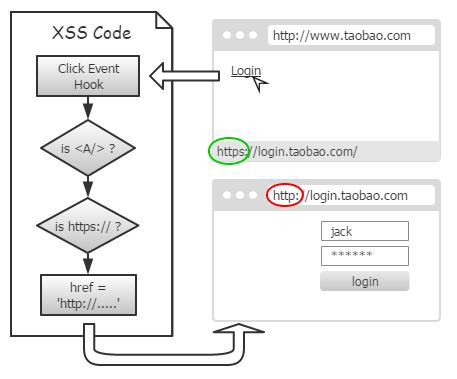
就那么简单。因为我们是在用户点下去之后才修改,所以浏览器状态栏里,显示的仍是原先 https !
当然,点过一次之后,再把鼠标放到超链接上,状态栏里显示的就是修改后的了。
为了能继续忽悠,我们在修改 href 之后的下个线程周期里,把它改回来。因为有了一定延时,新页面并不受影响。
```text
#!js var url = link.href; // 保存原始地址 link.href = url.replace('https://', 'http://'); // 暂时换成 http 的 setTimeout(function() { link.href = url; // 新页面打开后,还原回来 }, 0);
```
这样,页面里的超链接始终都是正常的 —— 只有用户点下的瞬间,才临时伪装一下。
## 0x03 更多拦截
除了通过超链接,还有其他方式访问页面,我们应尽可能多的进行监控。例如:
- 表单提交
- window.open 弹窗
- 框架页面
- .....
### 表单提交
表单提交和超链接非常类似,都具有事件,只是将 click 换成 submit,href 换成 action 而已。
### 脚本弹窗
函数调用的最简单了,只需一个小钩子即可搞定:
```text
#!js var raw_open = window.open; window.open = function(url) { // FIX: null, case insensitive arguments[0] = url.replace('https://', 'http://'); raw_open.apply(this, arguments); }
```
### 框架页面
因为我们把主页面降级成 http 了,但里面的框架地址仍是原先的。由于协议不同,这会产生跨域问题,导致页面无法正常工作。
所以我们还要把页面里的框架,也都转型成 http 版本,确保能和主页面融为一致。
但框架和之前的那些不同,因为它是自动加载的,而且也没有一个即将加载的事件。如果等到框架加载完了再去处理,说不定已经开始报跨域错误了。而且还会白白的浪费一次加载流量。
因此,我们必须让框架一出现,就立即替换掉地址。
这在过去是个很棘手的问题,然而 HTML5 时代给我们带来了新希望 —— MutationEvent。用它即可实时监控页面元素,之前也[尝试过一些试验](http://fex.baidu.com/blog/2014/06/xss-frontend-firewall-2/)。
当然,即使 MutationEvent,偶尔也会有延时遗漏。为了能彻底避免出现 https 框架页,我们继续使用 HTML5 带来的一项新技术 —— [Content Security Policy](http://www.w3.org/TR/CSP/),由于它是浏览器原生支持的,因此实施的非常彻底。
在我们的代理返回头中,加上如下 HTTP 头部,即可完美拦截 https 框架页了:
Content-Security-Policy: default-src * data 'unsafe-inline' 'unsafe-eval'; frame-src http://*
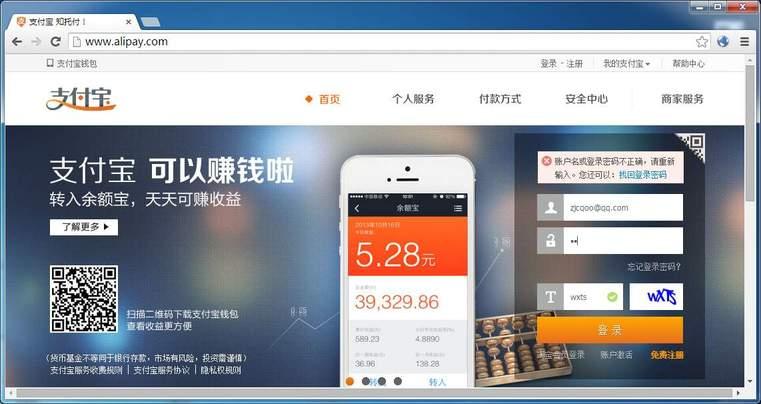
解决了框架页的问题,我们就能成功劫持支付宝登录页的账号框 IFrame 了!
## 0x04 后端配合
通过前端的 XSS 脚本,我们轻易解决了过去各种棘手的问题。但挑战并未就此结束,我们仍面临着众多难题。
### 如何告诉代理
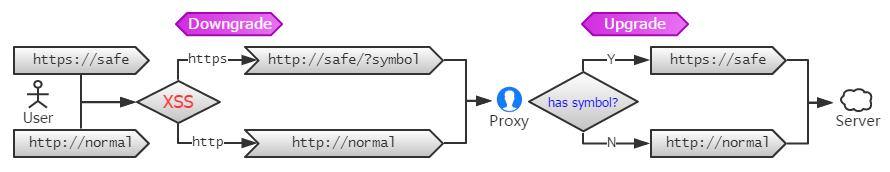
尽管在前端上面,我们已经避开了各种进入 https 的途径,让请求以明文的形式交给代理。但代理又如何决定,这个请求用 https 还是 http 转发呢?
传统的后端劫持之所以能正确转发,那是在替换超链接的时候,已经做下记录。当出现记录中的请求,就走 https 的转发。
而我们的劫持在前端,并且只发生在点击的一瞬间。即使马上去告诉中间人,某个 URL 是 https 的,这时也来不及了。
告诉中间人是必须的。但我们可以用一个巧妙的方法,不必单独发送消息 —— 我们只需在转型后的 URL 里,做个小记号就可以了。
当代理发现请求的 URL 里有这个记号,它自然就懂了,直接走 https!
由于把页面从 https 降级到了 http,因此相关请求的referer也变成 http 版了。所以,中间人应尽量把 referer 也修正回来,避免被服务器察觉。
### 隐藏伪装
不过,在 URL 里加标记的方法,也有很大的缺陷。
因为页面的 URL 会在地址栏里显示出来,所以用户会看见我们的记号。当然,我们可以使用一些迷惑性的字符,例如 ?zh_cn、?utf_8,?from_baidu 等等,更好的欺骗用户。
当然,如果你觉得还是不满意,也有办法让这些碍眼标记尽快消失:
```text
if url has symbol history.replaceState(..., clear_symbol(url) )
```
HTML5 为我们提供了修改地址栏的能力,并且无需刷新。这些强悍的功能,如今都可以在前端利用起来了。
### 重定向劫持
当然,光靠前端的劫持,还是远远不够的。现实中,还有另一种很常见的方式,那就是重定向到安全页面。
仔细回想下,平时我们是怎样进入想上的网站的。例如支付宝,除非你有收藏,否则就得自己敲入 www.alipay.com 或 www.zhifubao.com,当你回车进入时,浏览器又如何知道这是个 HTTPS 的网站呢?
显然,第一个请求仍是普通的 HTTP 协议。当然,这个 HTTP 版的支付宝的确存在,它的唯一功能就将用户重定向到 HTTPS 版本。
当我们的中间人一旦发现有重定向到 HTTPS 网站的,当然不希望用户走这条不受自己控制的路。于是拦下这个重定向,然后以 HTTPS 的方式,获取重定向后的内容,最后再以 HTTP 明文的方式,回复给用户。
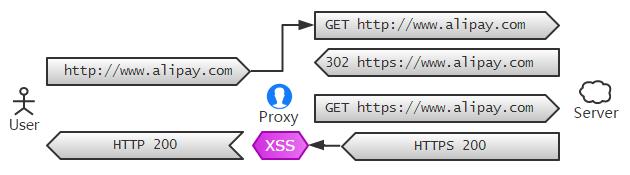
因此在用户看来,始终处于 HTTP 网站上。
不过,如今的 Web 里增加一个新的安全标准:[HTTP Strict Transport Security](https://www.owasp.org/index.php/HTTP_Strict_Transport_Security)。如果客户端收到这个头部,之后一段时间内访问该站点,就始终通过 HTTPS 的方式。
所以我们的中间人一旦发现有这个字段,就得果断将其删除。
当然,用户直接敲网址的并不常见。大多都是搜索引擎,然后直接从第一个结果里进来了。
比较悲剧的是,国内的搜索引擎几乎都是 HTTP 的。在用户访问搜索页面的时候,我们的 XSS 早已潜伏在其中了,因此从中点出来的任何一条结果,都是进不到官方的 HTTPS 里的:)
除了搜索页面,不少类似 hao123 之类的网址大全,大多也未开启 HTTPS。因此从中导流的网站,都面临着被中间人劫持的风险。
## 0x05 防范措施
介绍了攻击方法,接着讲解防御措施。
### 脚本跳转
事实上,无论是前端劫持还是后端过滤,仍有不少的网站无法成功。例如京东的登录:
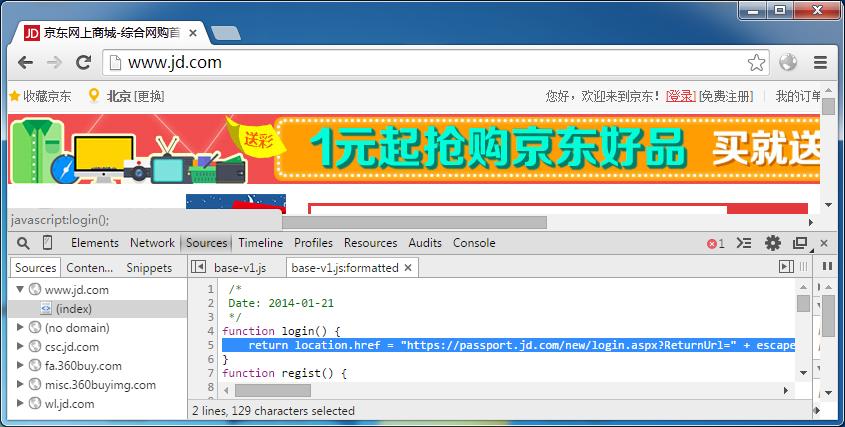
它是通过脚本跳转到 HTTPS 地址的。而浏览器的 location 是个及其特殊的属性,它[可以被屏蔽](http://stackoverflow.com/questions/22290948/stopping-script-from-changing-document-location-href),但无法被重写。因此我们难以控制页面的跳转情况。
如果非要劫持京东页面,我们只能使用白名单的方式,特殊对待该站点。但这样就大幅增加了攻击成本。
### 混淆明文
当然,不难发现京东的登录脚本里,URL 是以最直白的明文出现的。所以我们利用 SSLStrip 的方式,对脚本里的 https:// 的文本进行替换,也能起到一定的作用,毕竟大多脚本都对此毫无防备。
但对于稍微复杂一点的脚本,例如通过字符串拼接而成的 URL,那么就难以实施了。
所以在安全需要较高的场合,不妨把一些重要的地址进行简单的处理,中间人就无法使用通用的方式来攻击。而必须针对站点进行特殊对待,从而提高攻击成本。
### 尽可能多的 HSTS
之前提到 HSTS 头。只要这个字段出现过一次,浏览器在很长时间里都会只用 HTTPS 访问站点。因此,我们尽可能多的开启 HSTS。
现实中的劫持并非都是 100% 成功的,上述提到,使用脚本跳转很容易出现遗漏。所以,只要逮住用户一次遗漏,HSTS 就可以让之后的页面降级彻底失效了。
## 0x06 攻击演示
因为是前端劫持,所以 Demo 有两个文件:一个前端代码,另一个后端脚本(NodeJS)。
相关源码:[https://github.com/EtherDream/https_hijack_demo](https://github.com/EtherDream/https_hijack_demo)
相比之前写的流量劫持演示,这里功能更为专一,不再提供额外的劫持途径(例如 DNS 等)。
想测试其实非常简单,只需配置浏览器代理,即可模拟 HTTP 的劫持:
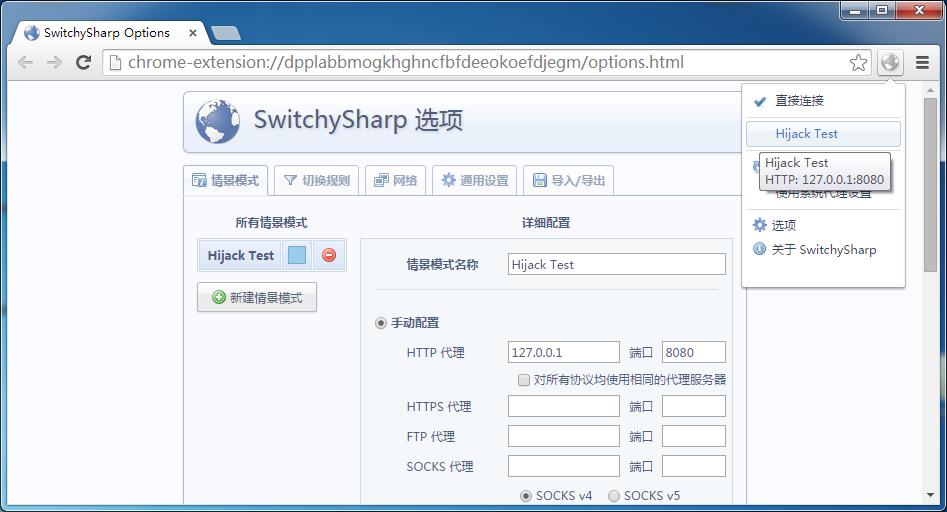
不嫌麻烦的话,也可以在 Linux 内核的系统上测试,转发 80 到本机即可。原理都是一样的。
我们随便找一个 HTTP -> HTTPS 网站做测试。
得益于前端脚本的优势,我们把鼠标放到登录超链接上,状态栏显示的仍是原始 URL:
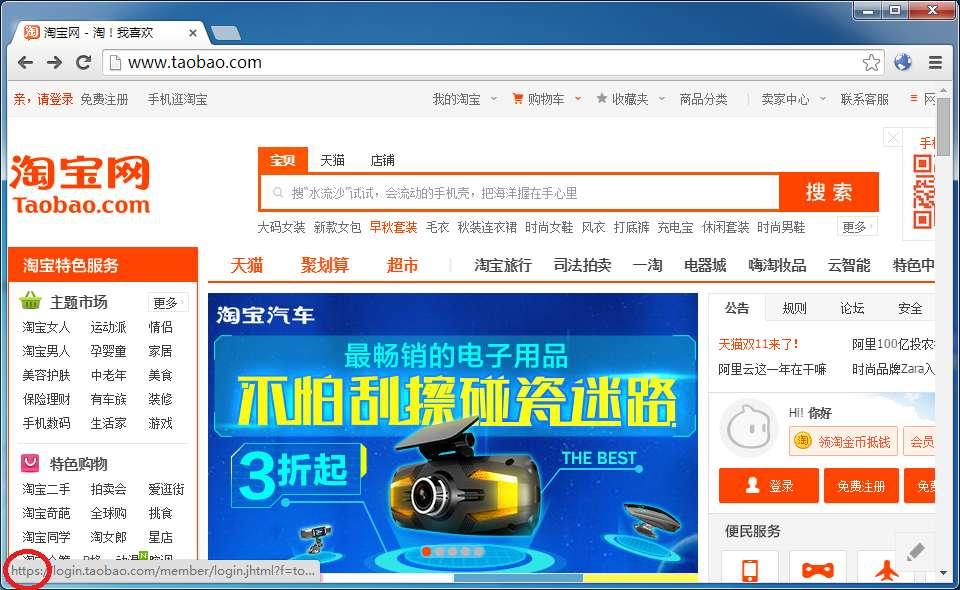
在我们点击的瞬间,暗藏页面中的 XSS 钩子触发了,成功把我们带到中间人虚拟的 HTTP 登录页面里。
当然,由于 URL 参数很多,地址栏里的那个记号看不到了。
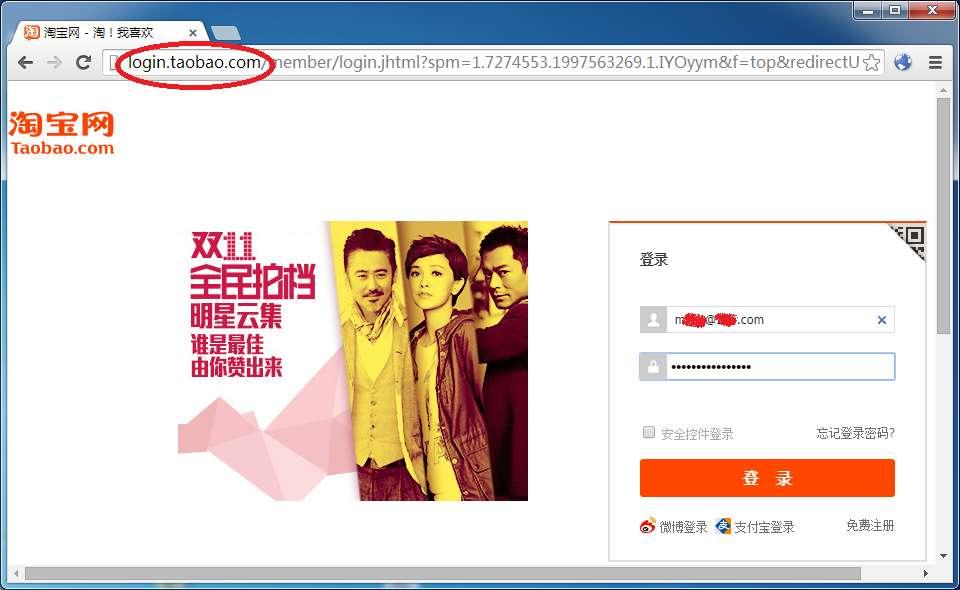
庆幸的是,淘宝的登录页面未进行地址判断,被降级后的页面仍然能登录成功!
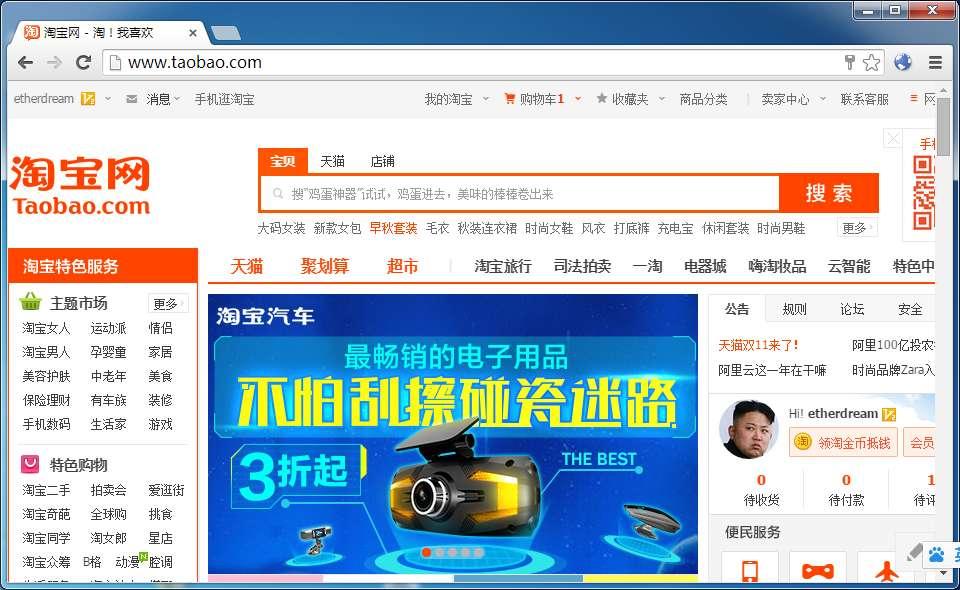
当然之前也说了,并非所有的页面都能劫持成功。
如今越来越多的网站都已重视,因此前端的安全性检测也随之而生。仅仅通过一个工具,实现大规模通用化的劫持,未来会更加困难。
但先比传统的纯后端实现,前后结合的方案能够带来更大的发挥空间。
## Replies